
A NVIDIA lançou o Nemotron 3.5 Super VL, um modelo aberto de 120 bilhões de parâmetros voltado a agentes especializados em operação contínua, com foco em velocidade de conclusão de tarefas e em precisão.
Junto com ele chegam dois modelos para edge: o Nemotron 3.5 Bolt 74B-A9B 24GB, equilibrado entre inteligência e velocidade por GB para cargas de trabalho locais baseadas em agentes, e o Nemotron 3.5 Bolt E4B 4GB, otimizado para inteligência por GB em agentes de conversação rápidos.
O Super VL e o Bolt 74B-A9B já estão disponíveis. O Bolt E4B chega em 23 de outubro.
Em conjunto, os três modelos abertos cobrem toda a faixa de implantação de agentes, do servidor corporativo de grande porte até dispositivos de edge e hardware local.
Qualquer organização que queira rodar agentes em infraestrutura NVIDIA passa a ter um modelo aberto e otimizado para o seu nível, sem precisar escolher entre capacidade e facilidade de implantação.
Super VL e Bolt se juntam à família Nemotron ao lado do Lightning e do Ultra.
O Lightning, lançado em agosto, atende cargas de trabalho de alta taxa de transferência; o Ultra cuida das tarefas de raciocínio mais difíceis; e o Bolt leva inteligência para o edge.
Nemotron 3.5 Super VL: precisão de nível de fronteira com um quinto do tamanho
Desenvolvido em colaboração com a Nemotron Coalition, o Super VL entrega precisão de destaque em tarefas multimodais baseadas em agentes: seguir instruções, usar ferramentas, executar fluxos de trabalho corporativos de várias etapas e interpretar conteúdo visual. O resultado é comparável ao maior modelo de raciocínio da NVIDIA, com cerca de um quinto da contagem de parâmetros.
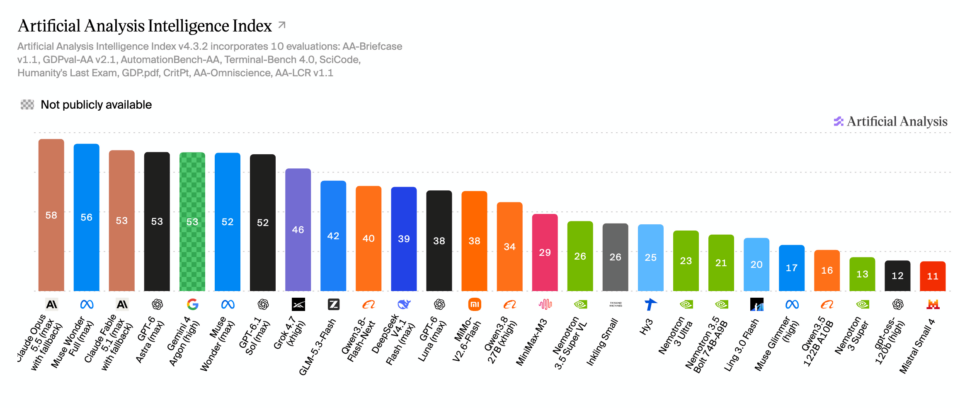
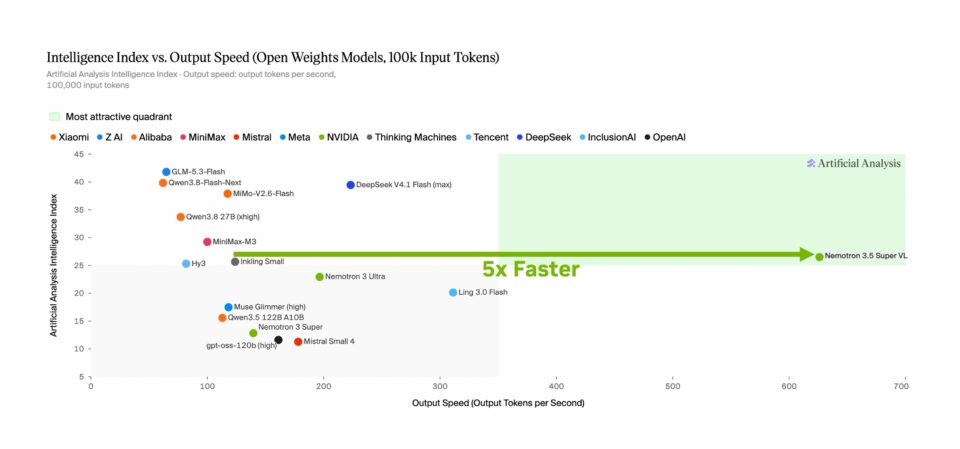
Segundo o Artificial Analysis Intelligence Index, é o modelo aberto baseado em agentes mais rápido da sua classe, 5x mais rápido que o segundo colocado, o que ajuda agentes corporativos a concluir tarefas de alto volume em fluxos que se estendem por dias ou semanas.
Diferentemente dos modelos de fronteira fechados, as organizações podem pós-treinar o Super VL com os próprios dados, implantá-lo na própria infraestrutura e supervisionar o que constroem.
Nemotron 3.5 Bolt: inteligência baseada em agentes no edge
O Bolt 74B-A9B 24GB foi projetado para executar tarefas cotidianas baseadas em agentes localmente em sistemas NVIDIA RTX, com quantização nativa de 2 bits para caber em 24 GB de memória e rodar ao lado de outras aplicações.
Em relação a outros modelos com consumo de memória semelhante, oferece um bom equilíbrio entre inteligência e velocidade: inteligente o suficiente para dar conta da maioria das tarefas e bem mais rápido que os modelos mais inteligentes.
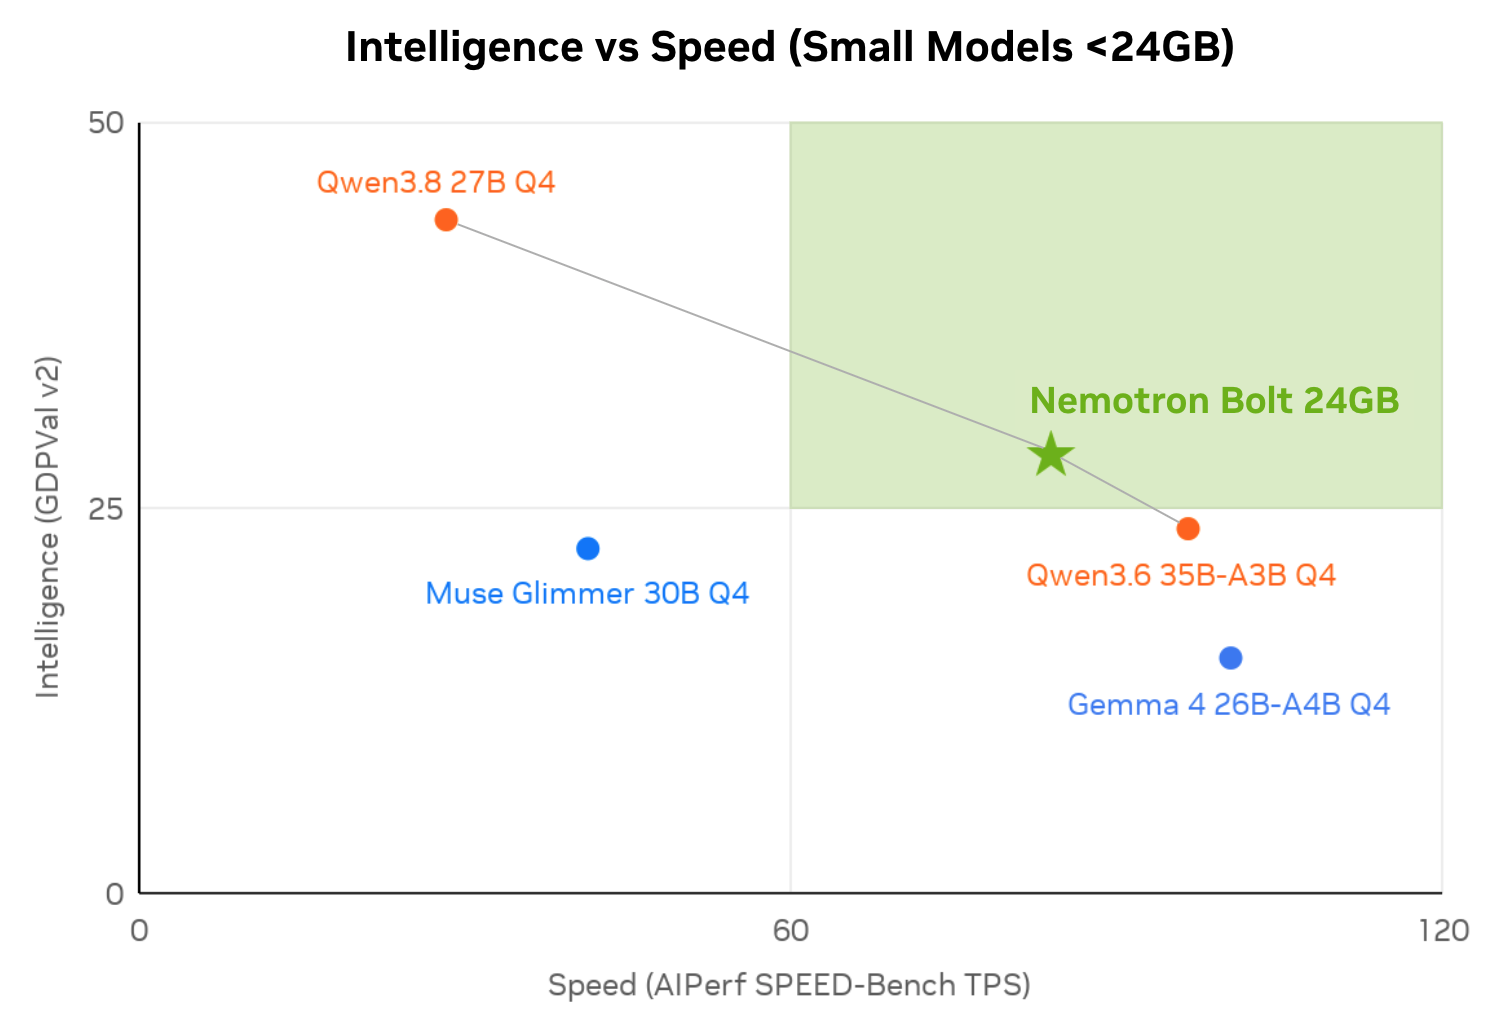
Com o Bolt 74B-A9B 24GB, é possível delegar projetos a harnesses populares de agentes locais, da pesquisa na web à escrita e à depuração de código, sem enviar essas cargas de trabalho para a nuvem. É o modelo aberto nº 1 da sua classe no PinchBench e o nº 2 entre os modelos abertos no BrowseComp.
O Bolt E4B 4GB foi criado para agentes físicos e de conversação em GeForce RTX e NVIDIA Jetson. Combina conversa natural com capacidades de agente em múltiplos turnos para viabilizar assistentes de voz locais rápidos, personagens interativos e interfaces embarcadas.
Adoção do Super VL personalizado
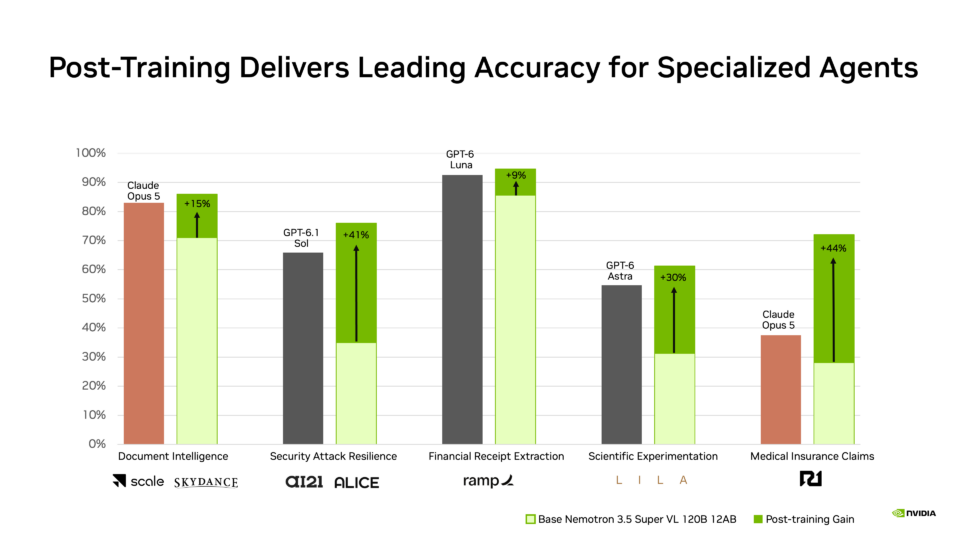
Dezenas de organizações de diferentes setores estão pós-treinando o Super VL com dados, ferramentas, políticas e fluxos de trabalho próprios para elevar a precisão nas tarefas especializadas que definem suas implantações de agentes.
A Scale AI pós-treinou o modelo para o agente de crédito a fornecedores da Skydance e para o agente de due diligence de fusões e aquisições da EY. A AfterQuery personalizou o modelo para a Hebbia, em análise de contratos de crédito. AI21 e Alice pós-treinaram o modelo para resiliência a ataques de cibersegurança. A Mercor pós-treinou o modelo no benchmark de código APEX-SWE, para agentes que planejam, escrevem e depuram código. O ModelScope permite fazer fine-tuning do modelo pelo framework ms-swift para aplicações multimodais especializadas.
Outras organizações que personalizam o Nemotron 3.5 Super VL incluem a Ramp, para inteligência de documentos financeiros; a Dream, em pesquisa de cibersegurança e análise de vulnerabilidades com IA nacional; a Lila Sciences, para descoberta e busca científica; e a R1, para análise de sinistros médicos e gestão do ciclo de receita. A TrainLoop pós-treinou o modelo com dados de dermatologia da Nolla, empresa que recebeu aprovação para uso de IA na emissão de prescrições iniciais a pacientes.
Entre as empresas de plataforma de software que estão integrando o Nemotron 3.5 Super VL:
- Atlassian, para tarefas como busca baseada em agentes em aplicações como Jira e Confluence.
- CrowdStrike, que está personalizando o modelo para blue teaming baseado em agentes em segurança corporativa.
- Dassault Systèmes, em projeto e simulação de engenharia.
- Perplexity, para busca e tarefas baseadas em agentes no Perplexity Search e no Computer.
- Salesforce, que está personalizando o Nemotron para agentes de IA que digitalizam e automatizam fluxos de trabalho governamentais complexos em ambientes seguros de clientes, por meio do Missionforce Operations.
- Synopsys, cujo software de verificação de projeto de semicondutores interopera com o modelo.
O que o Nemotron 3.5 Super VL enxerga
Os pontos fortes de linguagem e visão do Nemotron 3.5 Super VL miram o que os agentes encontram na prática: reconhecimento óptico de caracteres, tabelas, gráficos e informação estruturada em documentos visuais.
O modelo processa uma página web, extrai texto, lê gráficos e tabelas e devolve insights a partir do que encontra. O mesmo vale para PDFs e outros documentos com os quais agentes costumam trabalhar.
O Nemotron 3.5 Super VL entende imagens, páginas web e PDFs, e age com base nesse entendimento. Combinar compreensão de texto e de imagem em um único modelo significa que os agentes não precisam rotear tarefas entre sistemas separados: o contexto se mantém enquanto o trabalho avança do documento para o dado e daí para a decisão.
Aberto para mais controle, segurança e privacidade
Abertura e personalização se reforçam. O modelo vem com pesos abertos, datasets abertos e receitas de treinamento.
O controle vale nos dois sentidos. As organizações podem rodar o modelo onde seus requisitos de segurança e de residência de dados determinarem. E escolhem adotar um modelo que podem adaptar, em vez de um modelo sujeito às restrições de um fornecedor.
Em seguros, por exemplo, um agente personalizado pode varrer sinistros em busca de indícios de fraude de forma recorrente. Em serviços financeiros, um agente pode revisar scores de crédito e sinalizar atividades em relação aos critérios de concessão da própria organização. O modelo permanece on-premises. Os dados permanecem privados.
A personalização é feita com o NVIDIA NeMo, pipelines em Python e datasets abertos.
O Nemotron 3.5 Super VL foi treinado com cerca de 26 trilhões de tokens entre pré-treinamento e pré-treinamento continuado, e depois pós-treinado com aproximadamente 3,8 milhões de amostras e aprendizado por reforço em dezenas de ambientes.
A NVIDIA também está publicando datasets abertos no Hugging Face que cobrem uso de ferramentas por agentes, finanças, seguimento de instruções, contexto longo, equidade e compreensão de linguagem e visão, junto com os ambientes de aprendizado por reforço no NeMo Gym.
O NVIDIA NIM empacota o modelo como um microsserviço pronto para produção, com configurações validadas e otimizadas e suporte de nível corporativo, atualizado a cada duas semanas com correções de segurança e melhorias de performance.
E com o modelo em execução no NVIDIA Dynamo, as organizações podem atender até 8x mais usuários com latência 85% menor.
O Nemotron 3.5 Super VL já está disponível no Hugging Face, no Open Router, na comunidade ModelScope e como NVIDIA NIM.
Roda em DGX Station, RTX PRO e GeForce RTX
O Nemotron 3.5 Super VL roda em toda a linha de hardware da NVIDIA: em DGX Station, em sistemas RTX PRO e RTX para inteligência local no desktop, no NVIDIA Jetson no edge, e em ambientes de data center e nuvem.
O Nemotron 3.5 Bolt 74B-A9B 24GB já está disponível no Hugging Face, com suporte a llama.cpp, Ollama, LM Studio, Unsloth e vLLM. Roda em PCs GeForce RTX, em DGX Station e em workstations RTX PRO.
Baixe os pesos abertos, explore os recursos de personalização com o NVIDIA NeMo ou leia o blog técnico para o detalhamento completo da arquitetura.
Acompanhe novidades sobre agentes, NVIDIA Nemotron e mais assinando as notícias da NVIDIA, participando da comunidade e seguindo a NVIDIA AI no LinkedIn, no Instagram, no X e no Facebook.
Explore tutoriais em vídeo e transmissões ao vivo no seu ritmo.
Veja o aviso sobre informações de produtos de software.