
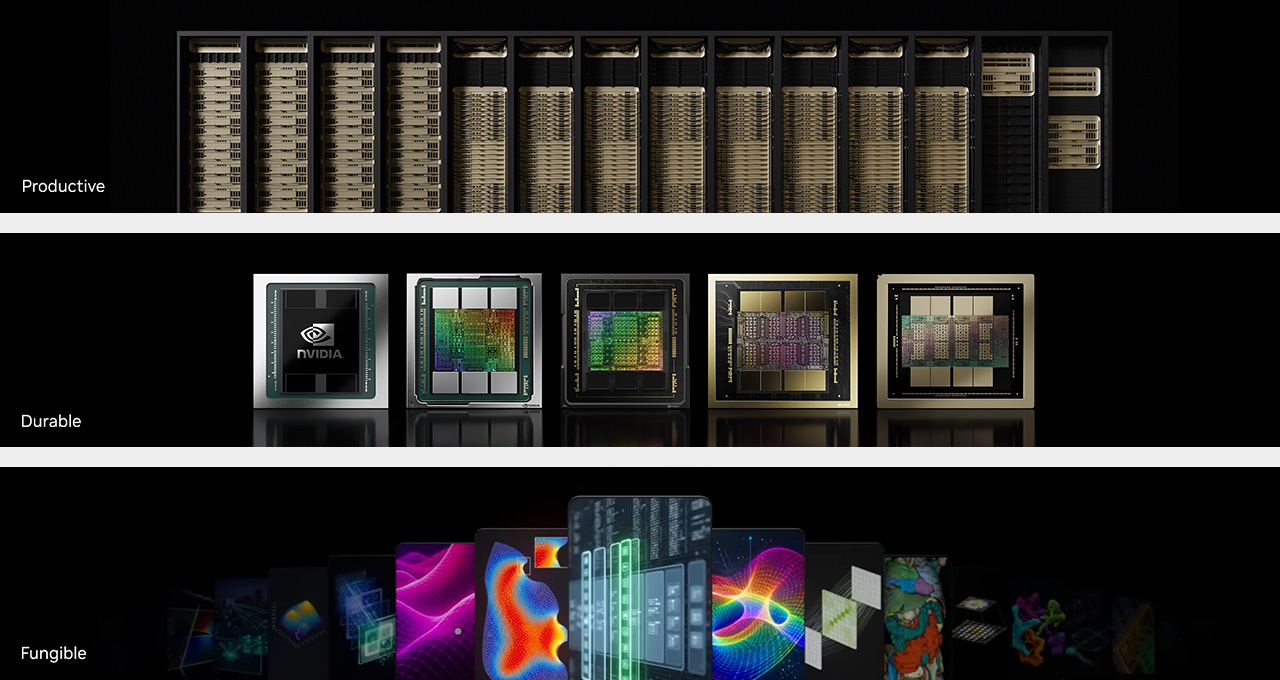
As fábricas de IA são construídas por megawatt, às vezes por gigawatt. Cada megawatt de fábrica custa cerca de US$ 60 milhões, e quem opera uma fábrica de IA só compromete capital nessa escala com uma visão clara do retorno sobre o investimento. Três fatores definem esse retorno:
- Capacidade de geração de receita: quanto a fábrica poderia faturar em um ano se vendesse todos os tokens que consegue produzir.
- Vida útil: por quanto tempo o hardware de IA continua gerando receita.
- Demanda: qual é a demanda por esses tokens.
A força em um fator não compensa totalmente a fraqueza em outro. Alta capacidade de geração de receita vale pouco se a fábrica vende só parte do que consegue produzir. Alta demanda importa pouco se a fábrica deixa de produzir a plena capacidade depois de apenas um ano. Os três também não são independentes: uma fábrica capaz de rodar mais tipos de carga de trabalho encontra mais demanda, o que a mantém gerando receita ano após ano.
As fábricas de IA da NVIDIA são projetadas para maximizar os três. Elas são:
- Produtivas: entregam a maior taxa de transferência por megawatt e o menor custo por token, o que maximiza a capacidade de geração de receita.
- Duráveis: as GPUs e os sistemas NVIDIA seguem gerando receita anos depois do envio, o que amplia a vida útil.
- Fungíveis: rodam todo tipo de IA, em todas as fases e em todos os lugares, além de muitas cargas de trabalho que não envolvem IA, o que aprofunda e amplia a demanda que podem atender.
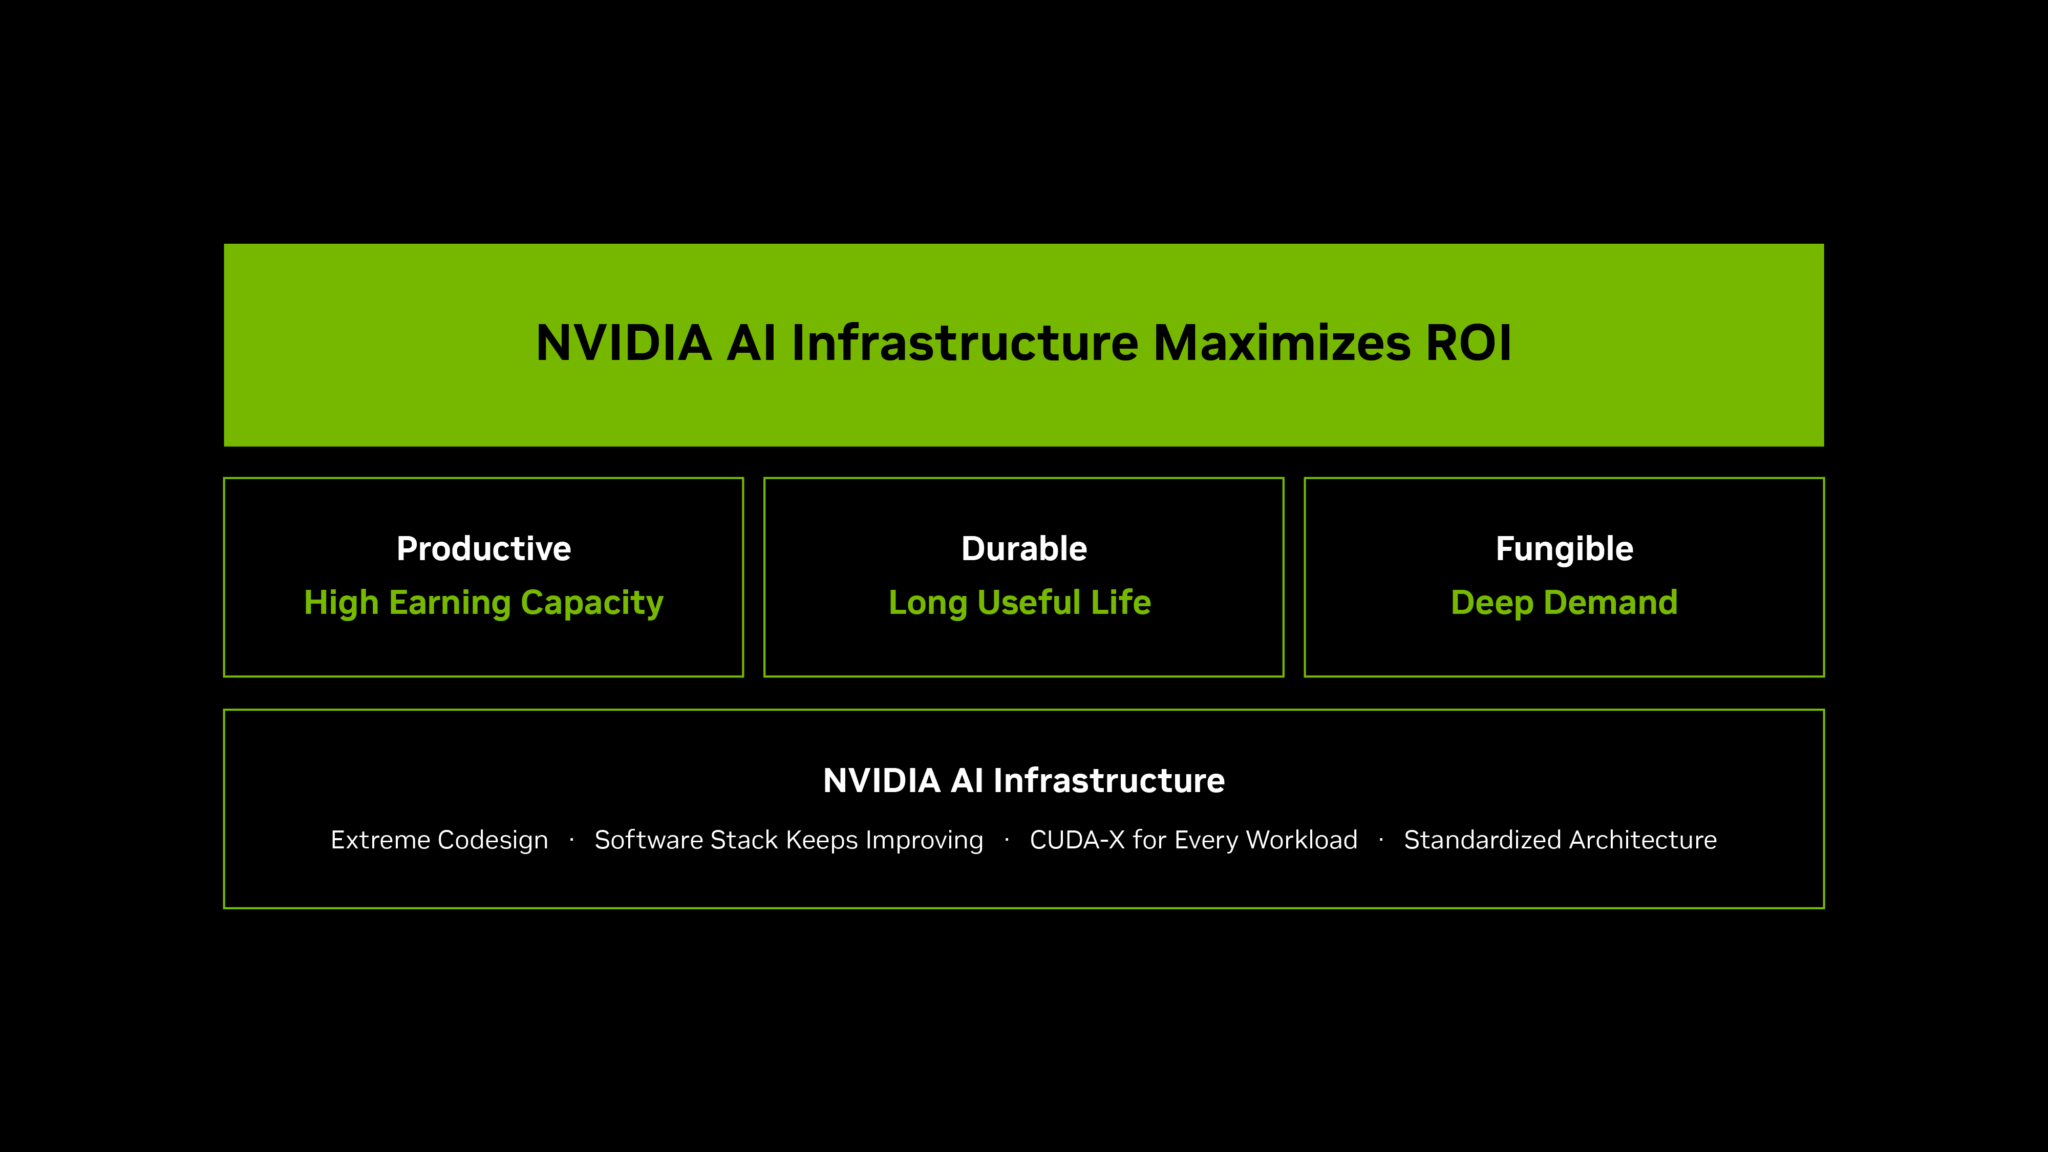
O codesign de engenharia em toda a stack maximiza a taxa de transferência da fábrica de IA, e a otimização contínua de software mantém o hardware já instalado produtivo anos depois do envio. As bibliotecas NVIDIA CUDA-X permitem que uma fábrica rode qualquer carga acelerada. Uma arquitetura padronizada coloca tudo isso ao alcance de qualquer operador, com implantação a partir de um design de referência validado.
Produtivas: Maior Número de Tokens por Megawatt e Menor Custo por Token
A energia é a restrição que limita uma fábrica de IA. Isso faz dos tokens por segundo por megawatt o número que governa a capacidade de geração de receita. Mais tokens dentro de um mesmo limite de potência significam mais receita. Menor custo por token significa mais margem sobre ela.
Dados do SemiAnalysis AgentX mostram que os sistemas NVIDIA Vera Rubin NVL72 entregam uma taxa de transferência por megawatt mais de 30x maior do que a do NVIDIA GB300 NVL72, e um custo por milhão de tokens até 45x menor no modelo DeepSeek V4 Pro. Ganhos dessa ordem vêm de codesign extremo em toda a stack: dos modelos e das cargas de trabalho, passando pelo software, até computação, rede e memória, tudo otimizado em conjunto.
Duas perguntas vêm na sequência. Se cada geração torna os tokens drasticamente mais baratos, a demanda por computação encolhe?
Não, ela se expande.
Tokens mais baratos tornam mais casos de uso economicamente viáveis, e esses casos de uso consomem mais tokens do que a eficiência economizou.
A segunda pergunta é sobre durabilidade. Se cada geração é tão superior à anterior, o que acontece com as gerações mais antigas?
Duráveis: A Base Instalada Continua Gerando Receita
Nem toda carga de trabalho precisa do sistema mais novo. O encaixe certo depende da complexidade e do formato da carga, e é por isso que a geração anterior continua gerando receita depois que a próxima chega.
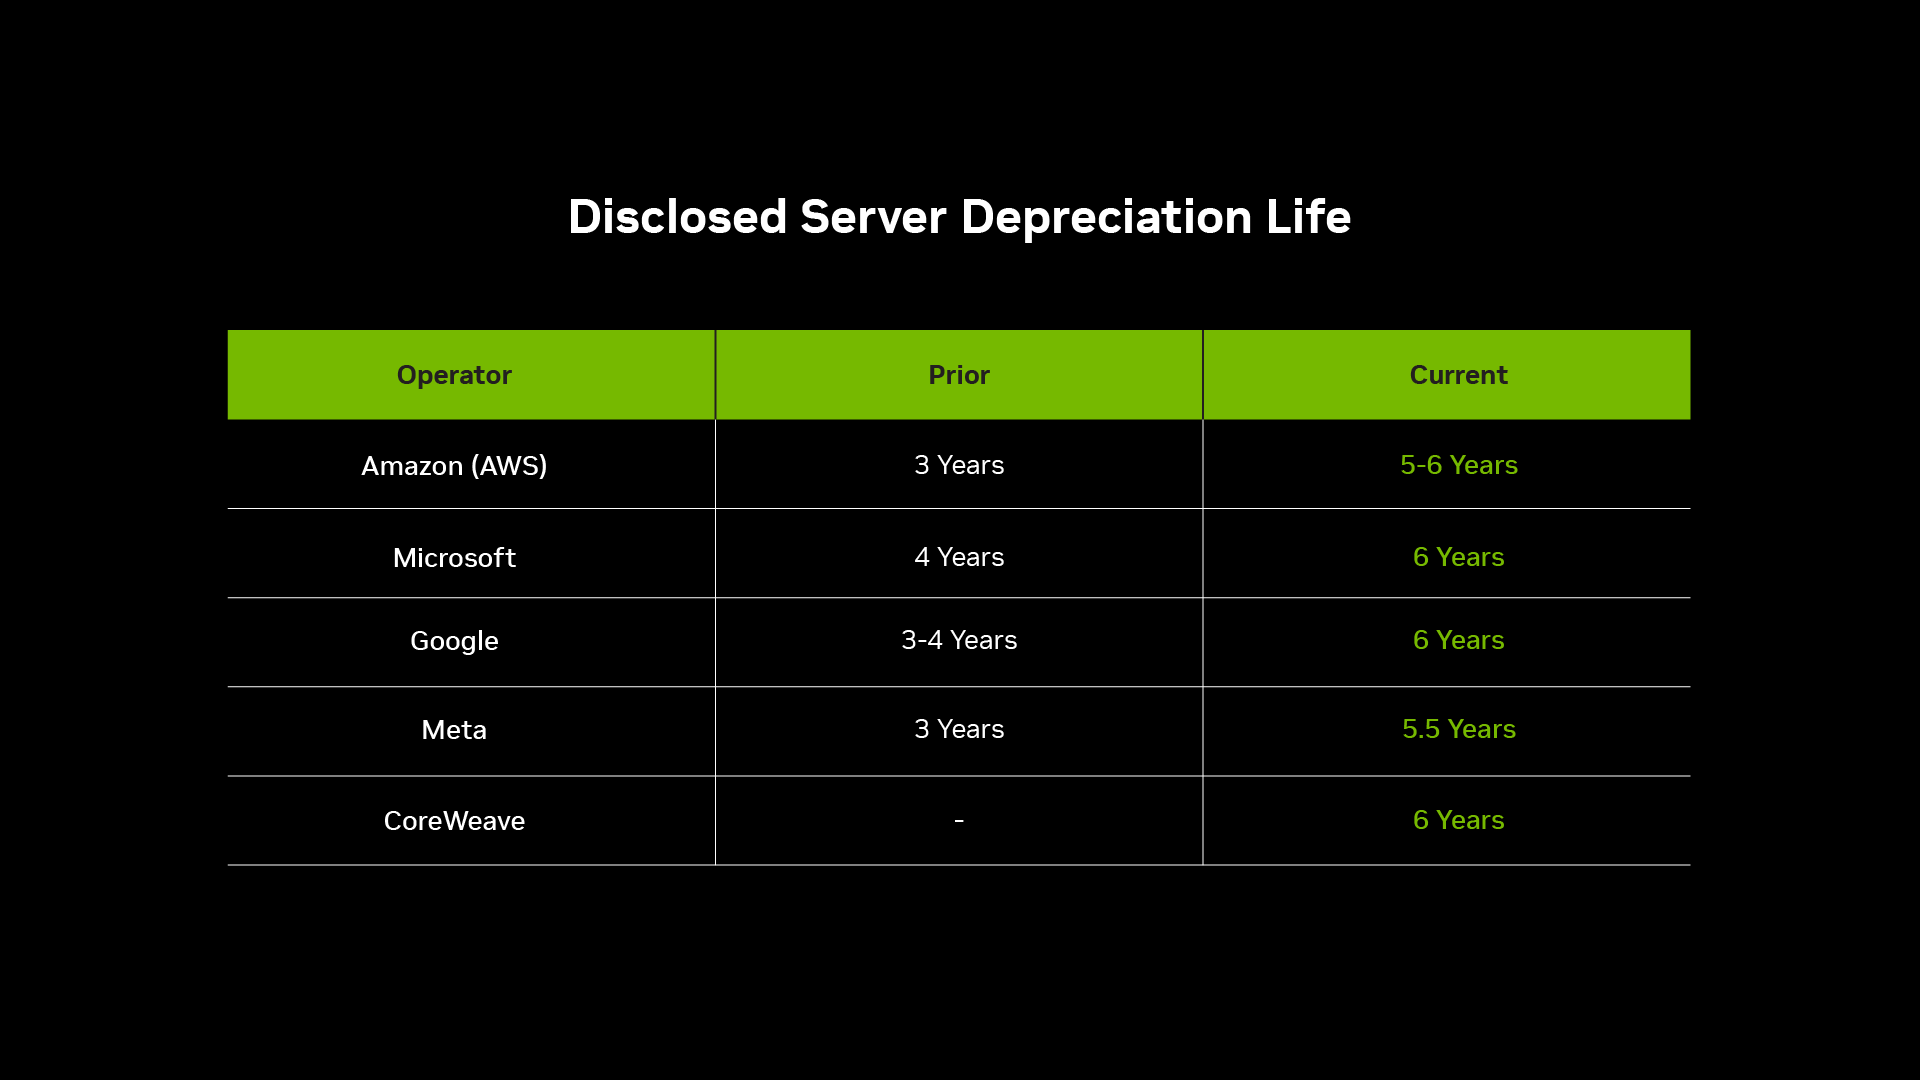
A GPU NVIDIA A100 começou a ser enviada em 2020 e segue em serviço comercial seis anos depois, o que demonstra seu valor econômico contínuo. A CoreWeave estendeu recentemente até 2029 as reservas de unidades lançadas em 2020. Ao longo dos anos, todos os grandes operadores estenderam o cronograma de depreciação dos seus servidores, que é uma aposta sobre quando o hardware deixa de gerar receita, e uma aposta que não para de ser empurrada para a frente. Uma análise da Sprout de setembro de 2026, “The Productive Life of a Data Center GPU“, acompanha como esse cronograma mudou em todos os grandes operadores.
A Barkr estima a vida útil em cinco a seis anos para um sistema de oito GPUs H100 e em nove a dez anos para o GB300 NVL72, com base no valor de revenda desses sistemas. A Silicon Data mostra que uma GPU A100 de seis anos ainda vale um quarto do que custou, enquanto um cronograma de depreciação de cinco anos já a tinha zerado há mais de um ano. A Ornn Data constata que o mercado paga 80% do valor para alugar uma GPU A100 em um contrato de cinco anos em relação a um contrato de um mês.
O CUDA, a plataforma de software com que as GPUs NVIDIA são programadas, funciona em todas as gerações, então nada do que um operador já tem fica preso quando uma nova arquitetura chega. A otimização contínua de software e de kernels segue melhorando o que o hardware existente consegue fazer.
A mesma plataforma roda machine learning, deep learning, IA generativa, raciocínio, IA baseada em agentes e IA física. Cada novo tipo de trabalho chegou em hardware que já estava instalado.
Isso é fungibilidade. Quanto mais tipos de trabalho um sistema aceita, por mais tempo ele continua encontrando trabalho.
Fungíveis: Todo Tipo de IA, em Todas as Fases, em Todos os Lugares
Uma fábrica construída para um único tipo de trabalho é uma aposta de que esse trabalho vai continuar existindo. Uma fábrica que roda tudo segue útil e gerando receita mesmo quando o trabalho muda.
As fábricas de IA da NVIDIA rodam todo tipo de modelo de IA, aberto e proprietário, em linguagem, visão, biologia, física e robótica. Rodam todas as fases, do processamento de dados ao pré-treinamento, pós-treinamento e inferência. E rodam em todos os lugares, de nuvens hiperescala e nuvens de IA a programas de IA nacional, data centers corporativos e o edge.
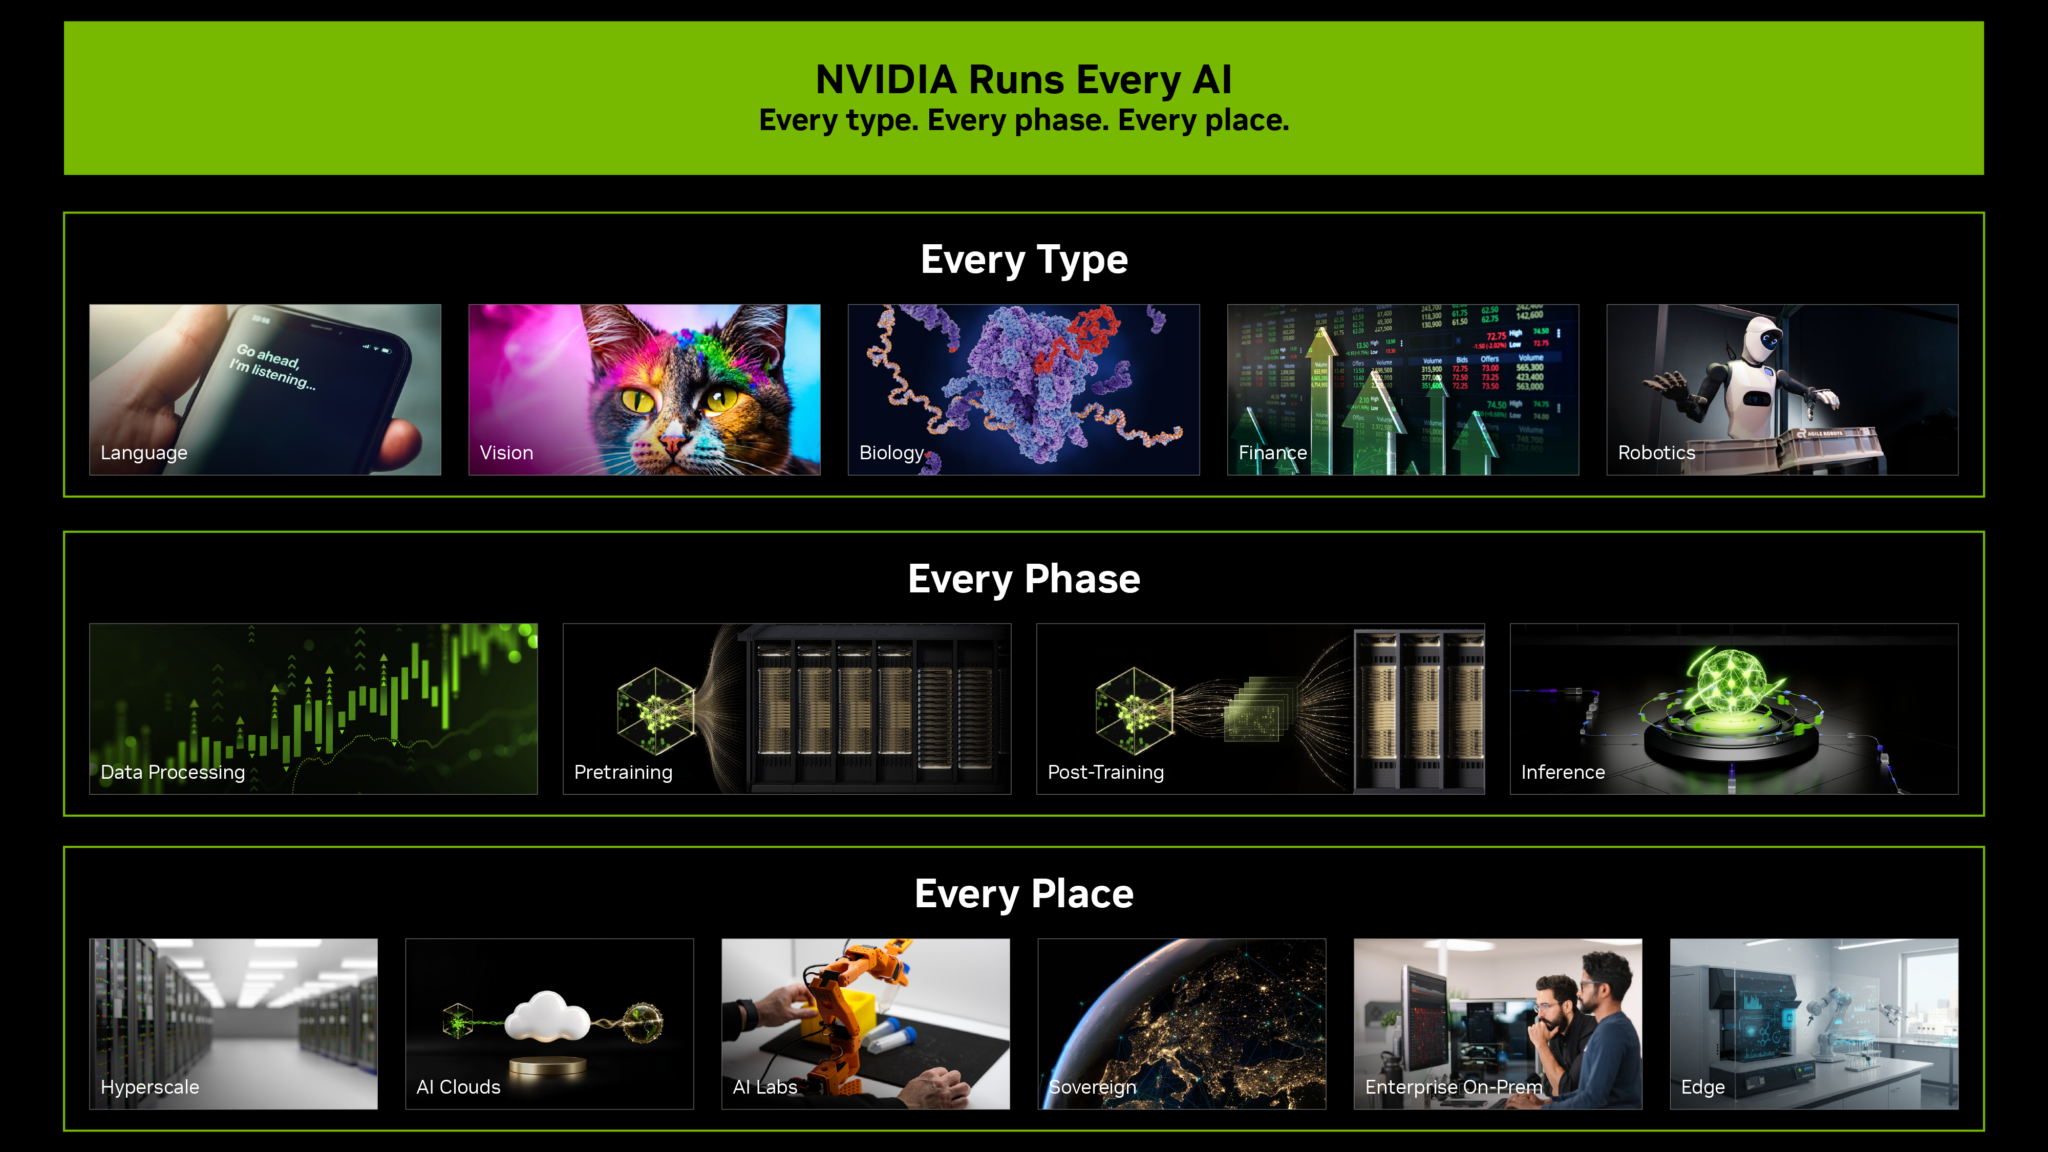
Nem tudo isso é construir e rodar modelos de IA. A mesma infraestrutura roda processamento de dados, computação científica, simulação, gráficos e mais.
Todas essas cargas de trabalho, de IA e fora de IA, se reduzem à mesma matemática paralela, e as GPUs NVIDIA são feitas para rodar exatamente isso em milhares de núcleos ao mesmo tempo. O CUDA é o motivo pelo qual um mesmo chip consegue simular luz, dobrar uma proteína e prever o próximo token. Mais de mil bibliotecas CUDA-X prontas se apoiam nisso, cobrindo de redes neurais profundas, litografia computacional e simulação de circuitos quânticos a busca vetorial e modelagem climática, com mais de 10 milhões de desenvolvedores construindo sobre elas.
É isso que faz das GPUs NVIDIA computação acelerada de propósito geral, e não um ASIC personalizado para uma única carga de trabalho. Ser de propósito geral não significa ser genérico: os Tensor Cores e o Transformer Engine colocam hardware otimizado para IA dentro de uma arquitetura programável, entregando especialização e flexibilidade no mesmo chip. Uma única arquitetura rodando tudo é o que mantém a utilização alta, e o retorno junto com ela.
Essa versatilidade aparece em produção nos clientes:
- Lilly: constrói e roda modelos de proteínas, de moléculas pequenas e de genômica em um cluster on-premises de 1.016 GPUs, além de chatbots e fluxos de trabalho baseados em agentes para os próprios times.
- Pinterest: faz pós-treinamento e implantação de um modelo de visão e linguagem em nuvem hiperescala, em 14 mil GPUs que abrangem as arquiteturas NVIDIA Blackwell, Hopper e anteriores.
- Revolut: processa dados de bilhões de registros de transações com o NVIDIA cuDF e depois treina e implanta um modelo de base em uma nuvem de IA.
- Runway: treina um world model em NVIDIA Hopper e faz o atendimento na plataforma NVIDIA Blackwell, usando infraestrutura em nuvem.
- Texas A&M University: roda simulação molecular e descoberta de medicamentos com IA em seu supercomputador, com 95% a 98% de utilização em 26 projetos e sete instituições.
O mesmo vale para além da IA. A Cosm opera um data center distribuído impulsionado por NVIDIA que fornece recursos flexíveis de computação para reprodução de vídeo em alta resolução, streaming, gráficos em tempo real e exibição sincronizada. A Dassault Systèmes sustenta a simulação de gêmeo virtual por trás da certificação de aeronaves na Wichita State University e do projeto de veículos na Lucid Motors. E a Unilever cria imagens de produto a partir de gêmeos digitais em vez de sessões de fotos, cortando pela metade o custo de produção.
Nenhuma lista de exemplos aqui seria completa, e esse é justamente o ponto.
As fábricas de IA da NVIDIA são projetadas para serem produtivas, duráveis e fungíveis: tokens mais lucrativos, vida útil mais longa e demanda mais profunda. É isso que maximiza o retorno delas.