
A inteligência de ponta está se tornando local. Na IFA 2026, a NVIDIA, a Microsoft e seus parceiros estão se unindo para fornecer inferência mais rápida e novas ferramentas que facilitam a configuração e a execução local de agentes em hardware NVIDIA. Os novos PCs compactos NVIDIA RTX Spark com Windows também chegam em outubro para oferecer aos entusiastas, desenvolvedores e criadores de IA mais maneiras de executar agentes poderosos de forma local e segura.
Os anúncios de hoje incluem:
- Suporte simplificado para IA local em GPUs NVIDIA estará disponível no Hermes Agent, OpenClaw e Perplexity Portable Computer.
- Inferência local até 1,9 vezes mais rápida — novas otimizações para llama.cpp e vLLM já estão disponíveis diretamente e através do LM Studio e do Ollama.
- NVIDIA PAIR — uma ferramenta de roteador de IA pessoal que distribui de forma inteligente a inferência de IA entre os PCs na rede local de um usuário.
- NVIDIA RTX Spark chega em outubro — com novos PCs Windows da Lenovo e da Acer. Electronic Arts, Embark e Ubisoft estão entre as mais recentes editoras e desenvolvedoras de jogos que trarão seus títulos de sucesso para o NVIDIA RTX Spark.
Além disso, agosto foi um mês movimentado para a IA local:
- O Nemotron 3.5 Lightning — que pode ser executado em PCs NVIDIA RTX, workstations RTX PRO, DGX Spark e Jetson — é um modelo com 30 bilhões de parâmetros que já está disponível. Comece a usar o Nemotron 3.5 Lightning hoje mesmo.
- O GLM-5.3-Flash da Z.ai é um modelo multimodal de mistura de especialistas (MoE) que está trazendo IA ativa para a DGX Station.
- A Qwen lançou o Qwen3.8-Flash-Next, um modelo MoE multimodal de peso aberto, que pode ser executado localmente no DGX Spark e no DGX Station, juntamente com o Qwen3.8-27B , um modelo aberto com 27 bilhões de parâmetros otimizado para cargas de trabalho de codificação e agentes locais em GPUs NVIDIA.
- O LTX 2.5 da LTX é um modelo de geração de vídeo de mundo aberto otimizado para GPUs NVIDIA RTX, DGX Spark e DGX Station, com novos aprimoramentos no NVFP4, FastVideo e ComfyUI para uma geração local mais rápida e com maior eficiência de memória.
- MiniMax-H3 é um modelo de geração de vídeo de baixo peso com áudio sincronizado que pode ser executado localmente em GPUs NVIDIA através do ComfyUI. A FastVideo uniu-se a pesquisadores da NVIDIA para aprimorá-lo ainda mais, lançando o FastH3 — uma versão destilada de quatro etapas e de baixo peso que melhora o desempenho em 7 vezes. Receitas FastVideo otimizadas para GPUs NVIDIA RTX e DGX Spark estarão disponíveis em breve.
- O Muse Glimmer da Meta é um modelo open-weight de 30 bilhões de parâmetros para cargas de trabalho de codificação e agentes, que pode ser executado localmente em PCs com GeForce RTX, DGX Spark, DGX Station e Jetson. A NVIDIA também lançou a quantização NVFP4 com suporte para DGX Spark, para uma implementação local mais eficiente em termos de memória.
- O DeepSeek v4 Flash é um modelo MoE com 284 bilhões de parâmetros, sendo 13 bilhões deles parâmetros ativos, que pode ser executado localmente em um cluster 2x DGX Spark e na DGX Station.
Um começo mais simples para agentes locais
Configurar e executar um agente local com modelos locais exigia algum esforço — escolher um modelo, encontrar um servidor de inferência compatível, ajustar as configurações de quantização e manter tudo atualizado. Essa dificuldade está desaparecendo nos sistemas RTX e DGX.
Três dos aplicativos de agentes mais utilizados oferecerão configuração simplificada de modelos locais no Windows, cada um baseado em llama.cpp e incorporando as mais recentes otimizações de inferência da NVIDIA. As novas experiências de configuração foram projetadas para reduzir a configuração manual e facilitar a instalação e execução de agentes locais.
No mês passado, a Perplexity lançou seu agente para Portable Computer, oferecendo aos usuários uma maneira simples de executar o Perplexity localmente em sistemas Linux, como o NVIDIA DGX Spark, com os modelos, a orquestração e as ferramentas reunidos em uma única aplicação.
O Perplexity Portable Computer está disponível para GPUs NVIDIA RTX com pelo menos 24 GB de VRAM rodando em Linux, com suporte para Windows em breve, levando essa mesma configuração simplificada para um grupo maior de usuários de PC. Os usuários podem executar fluxos de trabalho completos localmente sem consumir créditos, enquanto podem, seletivamente, encaminhar partes de uma tarefa para um dos mais de 15 modelos de ponta na nuvem quando pesquisas ou raciocínio adicionais forem necessários. O Portable Computer solicita permissão antes de enviar conteúdo para a nuvem, ajudando os usuários a manter informações confidenciais em seus dispositivos. Aqui estão alguns exemplos de casos de uso:
- Engenharia: Analisar os PRs abertos em um repositório GitHub conectado e classificá-los em prontos, bloqueados, obsoletos e precisam de revisão, cada um marcado com a próxima etapa. Documentações que ficaram desatualizadas em relação à última mesclagem são identificadas e corrigidas, com um PR aberto para as alterações.
- Finanças: Mostre ao agente dois anos de resumos de corretagem, formulários 1099 consolidados e declarações de imposto de renda e peça que ele rastreie as participações recorrentes que geram as taxas e impostos mais evitáveis, com cada valor citado até o arquivo e página exatos — tudo isso sem que nenhum documento chegue ao chatbot.
- Startups: Ao perguntar por que a ativação estagnou, o agente analisa localmente o funil de vendas para identificar os pontos em que as novas inscrições caem entre a instalação e a conclusão da primeira tarefa, e publica as principais informações diretamente no canal do Slack da equipe.
Experimente o Portable Computer hoje mesmo.
O Hermes Agent — desenvolvido pela Nous Research — é um agente de propósito geral usado por milhões de pessoas, que se destaca pela confiabilidade e capacidade de autoaperfeiçoamento. Independente de modelo e provedor, o Hermes foi projetado para funcionar o dia todo em sistemas locais, tornando-o ideal para PCs RTX, workstations RTX PRO e DGX Spark.
A configuração de um modelo local no Hermes proporcionará aos usuários uma configuração com um único clique em sistemas RTX e DGX no Windows. O agente detectará automaticamente a GPU NVIDIA, selecionará um modelo e configuração apropriados e o executará por meio do llama.cpp integrado com as otimizações de inferência da NVIDIA já implementadas, eliminando o download e o ajuste manual do modelo. O suporte para Linux estará disponível em breve.
Uma vez em execução, o Hermes funciona da mesma forma que em qualquer outro lugar. Ele utiliza ferramentas, mantém o contexto entre tarefas, memoriza informações entre sessões e cria habilidades reutilizáveis ao longo do tempo, permitindo que o agente se torne mais capaz com o uso contínuo. Executar o modelo localmente em uma GPU mantém o desempenho rápido, preservando os dados no sistema.
A configuração de modelos locais com um clique já está disponível no Windows, e em breve haverá suporte para Linux. Saiba mais sobre o Hermes Agent.
A OpenClaw se tornou um dos projetos definidores do movimento de agentes abertos — o maior projeto de IA no GitHub, com mais de 380 mil estrelas e uma comunidade em rápido crescimento que está criando ferramentas e habilidades em pesquisa, engenharia, gerenciamento de projetos e produtividade diária.
A NVIDIA, a Microsoft e a OpenClaw têm trabalhado em conjunto para facilitar a configuração desse modelo em PCs com Windows. Para reduzir as dificuldades iniciais, o aplicativo OpenClaw para Windows simplifica o processo de configuração de um modelo local otimizado em qualquer GPU RTX com pelo menos 24 GB de VRAM.
Saiba mais no blog da OpenClaw.
Inferência mais rápida impulsiona os agentes locais
O desempenho da inferência é crucial para manter os agentes locais responsivos. A NVIDIA continua colaborando com as comunidades de código aberto llama.cpp e vLLM para acelerar as cargas de trabalho de agentes em plataformas NVIDIA locais.
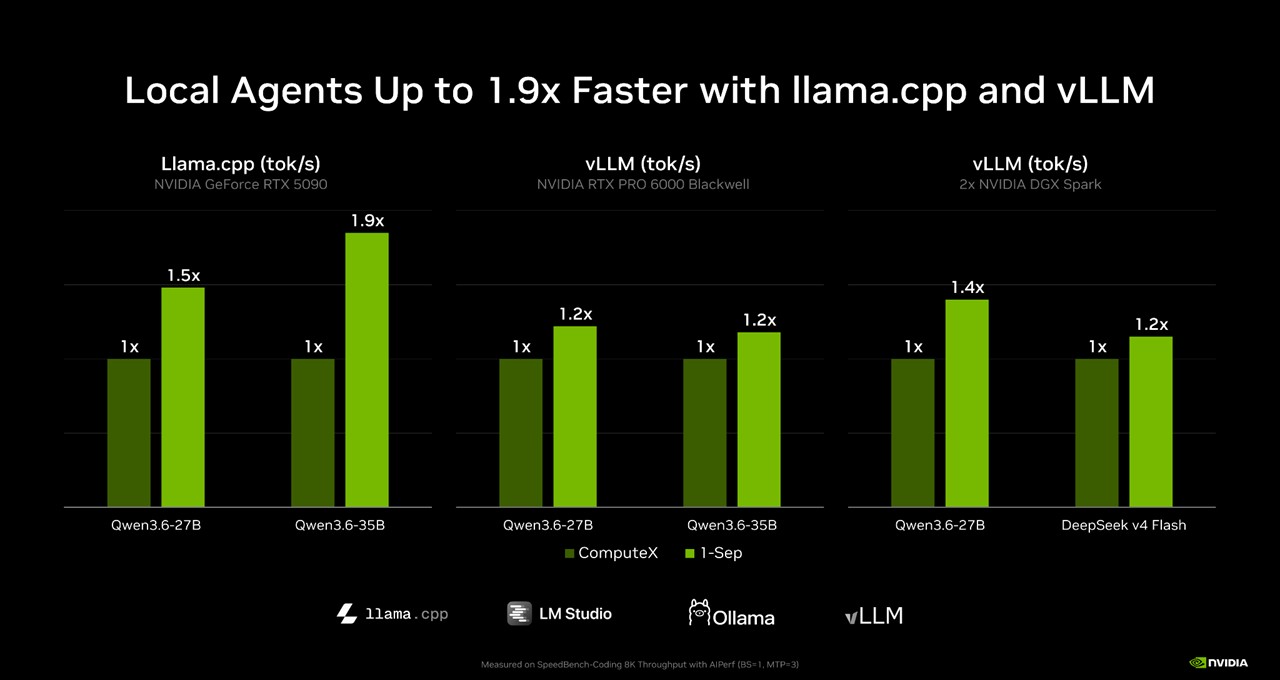
O llama.cpp oferece um aumento de desempenho de até 1,9 vezes graças às otimizações do kernel em uma GeForce RTX 5090, técnicas aprimoradas de decodificação especulativa e preenchimento automático mais rápido.
O vLLM oferece um aumento de desempenho de 1,2x na RTX PRO 6000 Blackwell Workstation Edition e até 1,4x em dois clusters DGX Spark. Novos kernels de atenção XQA no FlashInfer e otimizações de backend ajudam a acelerar a inferência em ambas as plataformas.
Esses ganhos estão disponíveis nos backends de inferência llama.cpp e vLLM.
Os usuários também podem experimentar esses recursos por meio dos aplicativos LM Studio e Ollama.
Aproveite PCs ociosos para obter mais poder computacional local de IA com o NVIDIA PAIR
Mais da metade dos lares americanos possui dois ou mais PCs, e grande parte desse poder computacional permanece ocioso durante o dia. O NVIDIA Personal AI Router (PAIR) é uma ferramenta de software livre e de código aberto que coloca esses sistemas para trabalharem juntos em inteligência artificial local.
Fluxos de trabalho com agentes frequentemente dividem tarefas complexas em trabalhos menores que podem ser executados em paralelo, mas o desempenho pode ser afetado quando cada solicitação compete pela mesma GPU. O PAIR descobre automaticamente PCs compatíveis em uma rede local e encaminha solicitações de inferência independentes para o sistema que tiver capacidade disponível. Ele funciona com o Ollama e o LM Studio e pode se adaptar conforme dispositivos entram ou saem da rede.
Por exemplo, um usuário poderia pedir ao Hermes para criar um plano de “Reinicialização de Domingo” organizando uma caixa de entrada desorganizada e priorizando o que precisa de atenção imediata, o que pode esperar e o que pode ser ignorado. O Hermes pode dividir esse trabalho entre vários subagentes, enquanto o PAIR distribui essas tarefas entre os PCs disponíveis, em vez de deixá-las todas aguardando em uma única GPU.
O resultado é mais poder de processamento para agentes locais, com mais tarefas sendo executadas em paralelo e a flexibilidade de mover cargas de trabalho de IA para outro PC enquanto o sistema principal está sendo usado para jogos, criação ou outros trabalhos.
A versão beta do NVIDIA PAIR está disponível para Windows, macOS e Linux através de interfaces gráficas e de terminal, com suporte para GPUs NVIDIA GeForce RTX Série 20 e mais recentes, GPUs para workstations NVIDIA RTX PRO (arquitetura Turing e mais recentes), NVIDIA DGX Spark e Apple M4 ou mais recentes.
Confira o blog de tecnologia da NVIDIA para começar a usar o NVIDIA PAIR.
Edição de fotos poderosa no próprio dispositivo com o modo PC do Cyberlink PhotoDirector AI no RTX Spark
Modelos abertos de imagem e vídeo permitem que artistas experimentem modelos de IA criativa em PCs. Isso possibilita que eles iterem e explorem conceitos e ideias sem a temida ansiedade relacionada a tokens, mantendo mais de seu trabalho criativo privado e no próprio dispositivo.
O novo Modo PC com IA do PhotoDirector da CyberLink é um dos primeiros aplicativos a integrar esses modelos de difusão diretamente em um software criativo, transformando-os em uma ferramenta criativa ao alcance dos artistas. Disponível no PhotoDirector 365 e otimizado para NVIDIA RTX Spark no lançamento, o Modo PC com IA oferece aos usuários ferramentas de edição com inteligência artificial para edição generativa, aprimoramento de imagem, remoção de objetos e distrações, remoção e substituição de fundo, refinamento de retratos e criação de visuais totalmente novos — com a flexibilidade de escolher entre processamento local ou em nuvem, dependendo da tarefa.
Em GPUs NVIDIA, o PhotoDirector usa TensorRT-RTX e FP8 para acelerar a IA local.
Comece a usar o software de edição de fotos PhotoDirector 365 da Cyberlink e saiba mais sobre o Modo PC com IA do PhotoDirector, que será lançado com o RTX Spark em outubro.
PCs com Windows e NVIDIA RTX Spark chegam em outubro de 2026
A NVIDIA RTX Spark chega em outubro — e na IFA 2026, as empresas parceiras estão exibindo seus hardwares. Na IFA, novos designs anunciados se juntam aos seis fabricantes que já lançarão seus produtos em outubro. A Acer apresentou seu conceito de desktop compacto com RTX Spark, e a Lenovo anunciou seus modelos Yoga Pro 9n e Yoga 9n 2 em 1.
O RTX Spark representa um novo começo para PCs com Windows. Um PC desenvolvido para criadores, jogadores e agentes de IA. Com uma poderosa GPU RTX Blackwell de 1 Petaflop, até 128 GB de memória unificada e uma CPU Grace de 20 núcleos altamente eficiente, o RTX Spark oferece desempenho e eficiência incríveis. Este superchip possibilita notebooks finos de alto desempenho com bateria para o dia todo e desktops compactos para executar agentes sempre ativos. Em conjunto com a nova estrutura do Windows Agent, ele permite que agentes sejam executados com segurança em segundo plano sob o controle do sistema operacional.
Na semana passada, durante a Gamescom, a Electronic Arts, a Embark e a Ubisoft estavam entre as mais recentes editoras e desenvolvedoras de jogos a trazer seus títulos de sucesso para PCs com Windows e placas de vídeo NVIDIA RTX Spark. Elas se juntam às editoras que anunciaram suporte ao RTX Spark na COMPUTEX em maio, incluindo a KRAFTON, a NetEase, a Riot Games e a XBOX. Leia mais.
Cadastre-se para ser notificado quando os notebooks e desktops RTX Spark estiverem disponíveis.
#ParaQuemPerdeu: Mais novidades da IA local da NVIDIA
 NVIDIA traz novas tecnologias e jogos RTX para a Gamescom — A NVIDIA lançou o DLSS 4.5 Ray Reconstruction, que apresenta um novo modelo transformer de segunda geração para melhorar a qualidade da imagem em jogos com ray tracing e path tracing. A Gamescom também trouxe novos anúncios de RTX para títulos como 007 First Light, CONTROL Resonant e Gears of War: E-Day, além de suporte expandido para a futura NVIDIA RTX Spark.
 Apresentamos o DeepSeek Harness — o novo harness de código aberto da DeepSeek, que se integra ao DeepSeek-V4-Flash para potencializar fluxos de trabalho de codificação agentiva local em configurações NVIDIA DGX Station e multi-DGX Spark.
 O MLPerf Client v2.0 expande os testes de desempenho de IA para PCs — A MLCommons lançou o MLPerf Client v2.0 , desenvolvido em colaboração com a NVIDIA e outros líderes do setor. A atualização adiciona novos benchmarks para IA ativa e geração de imagens, além de testes LLM expandidos para cargas de trabalho de IA local do mundo real.
Siga o NVIDIA RTX Spark no LinkedIn, Instagram, TikTok e Facebook — e mantenha-se informado assinando a newsletter NVIDIA Local AI. Siga o NVIDIA Workstation no LinkedIn e no LinkedIn.
Consulte o aviso referente às informações do produto de software.