
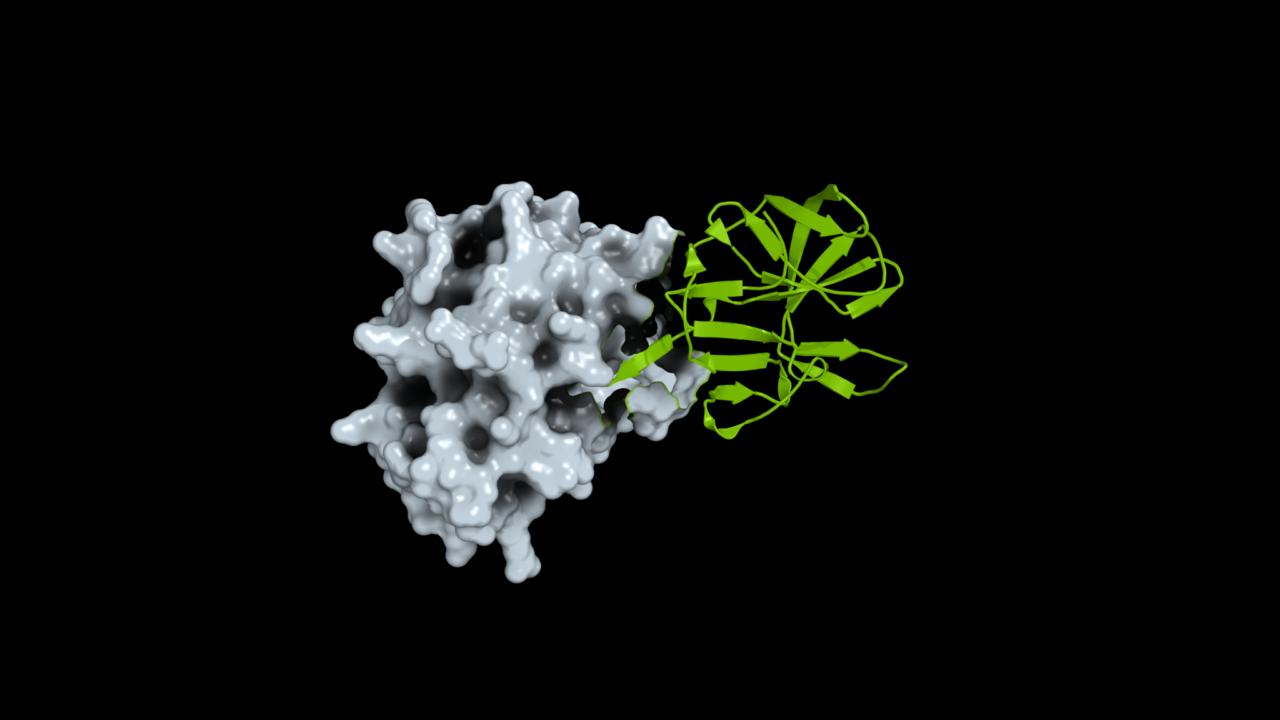
Quando a COVID-19 surgiu, os cientistas tinham uma vantagem decisiva: décadas de pesquisa anterior sobre coronavírus significavam que eles entendiam as principais proteínas do vírus bem o suficiente para projetar vacinas em tempo recorde. A próxima pandemia pode não oferecer a mesma vantagem inicial.
Para melhorar essas chances, a NVIDIA entrou em uma coalizão de organizações de pesquisa de todo o mundo, entre elas o Google DeepMind e o European Bioinformatics Institute (EMBL-EBI), do European Molecular Biology Laboratory, para liberar as estruturas 3D previstas dos complexos proteicos de mais de 2.800 vírus, abertas a qualquer cientista, em qualquer lugar, por meio do AlphaFold Database.
As estruturas do conjunto de dados recém-liberado foram inferidas com o AlphaFold2, o modelo de IA do Google DeepMind que prevê como as proteínas se dobram em formas tridimensionais, com otimização do NVIDIA BioNeMo Inference Runtime. Isso permitiu à equipe escalar a inferência para milhares de proteomas virais e prever os complexos, ou grupos de proteínas que interagem entre si, codificados dentro de cada vírus.
“Nossa ambição com o AlphaFold Database sempre foi democratizar o acesso à biologia fundamental em escala”, afirmou Risha Patel, gerente de parcerias em ciências da vida do Google DeepMind. “Esta colaboração, que traz milhares de complexos virais para o banco de dados, vai equipar cientistas do mundo inteiro com as informações de que precisam para ajudar a se preparar para surtos futuros.”
A NVIDIA também está liberando abertamente o BioNeMo Structure Prediction Pipeline, o fluxo de trabalho acelerado por GPU usado para gerar o conjunto de dados, para que pesquisadores possam ir da sequência da proteína à estrutura 3D prevista nos próprios alvos de estudo.
A preparação para a próxima pandemia precisa começar agora. Uma análise do Center for Global Development estima cerca de 50% de chance de o mundo enfrentar até 2050 uma pandemia tão grave quanto a de COVID-19.
“Quando a próxima pandemia acontecer, pode surgir algo completamente inesperado, e vamos estar sem o conhecimento que tínhamos para a COVID”, afirmou Joe Grove, professor de virologia molecular no Medical Research Council-University of Glasgow Centre for Virus Research e colaborador do projeto. “O que estamos tentando fazer é estocar parte desse conhecimento com antecedência.”
Cerca de 30% das interações entre proteínas que estão sendo acrescentadas ao banco de dados são completamente novas para a ciência e mostram formas de interação nunca documentadas no Protein Data Bank, o principal repositório de estruturas proteicas determinadas experimentalmente. Isso se traduz em informações novas para a comunidade de biologia explorar e aproveitar na geração de conhecimento.
“Este banco de dados é um motor de geração de hipóteses”, afirmou Chris Dallago, líder da equipe de pesquisa aplicada em biologia digital da NVIDIA. “Estamos permitindo que biólogos e a comunidade de IA investiguem interações entre proteínas, não apenas como moléculas isoladas, mas como complexos, para que todo o campo avance.”
Prever Estruturas de Complexos Proteicos
A maior parte das proteínas não trabalha sozinha: elas se juntam em complexos de várias moléculas para desempenhar funções sofisticadas. Essas estruturas costumam ser justamente o alvo que uma vacina ou um medicamento precisa atingir para interromper a função viral.
Entender a estrutura 3D da proteína spike do vírus da COVID-19, por exemplo, foi fundamental para o projeto das vacinas. Para milhares de outros vírus, não existe hoje nenhum conhecimento estrutural equivalente. Este conjunto de dados começa a preencher essa lacuna.
Os métodos tradicionais para determinar estruturas proteicas, que passam por cristalizar as proteínas e disparar raios X contra elas, podem levar anos e custar milhares de dólares por estrutura. O AlphaFold2, otimizado com o NVIDIA BioNeMo para rodar de forma eficiente em GPUs NVIDIA, prevê uma estrutura em minutos e pode ser executado em lote. Os cientistas podem então verificar as previsões de alta confiança por métodos experimentais.
Neste projeto, a equipe percorreu de forma sistemática as estruturas proteicas de famílias virais que se sabe infectarem humanos, dos vírus do resfriado comum a ameaças emergentes como a Mpox.
Uma Colaboração Global com Acesso Global
A colaboração reúne a Coalition for Epidemic Preparedness Innovations, o EMBL-EBI, o Google DeepMind, a NVIDIA, a Universidade Nacional de Seul, a Universidade Sungkyunkwan, o Swiss Institute of Bioinformatics e a Universidade de Glasgow.
A liberação do conjunto de dados contribui para o AlphaFold Database, que agora reúne mais de 260 milhões de previsões de proteínas e de complexos proteicos e cobre quase todas as proteínas que a ciência tem catalogadas. O anúncio coincide com uma reunião da Assembleia Geral das Nações Unidas convocada pelo Fórum Econômico Mundial sobre prevenção, preparação e resposta a pandemias, realizada esta semana em Nova York.
“Tornar esses dados abertos é essencial para entender diagnósticos virais e desenvolver tratamentos e vacinas”, afirmou Jo McEntyre, diretora interina do EMBL-EBI. “O conjunto de dados também cobre vírus menos estudados e reduz as barreiras para cientistas que trabalham em contextos com poucos recursos e enfrentam surtos na linha de frente.”
As previsões do conjunto de dados aberto vêm rotuladas por nível de confiança. As estruturas mostram como os complexos virais podem ser e como proteínas individuais podem interagir dentro de um proteoma viral.
De modo geral, os novos dados representam uma contribuição importante para as informações disponíveis a cientistas de biologia digital e de pesquisa em doenças.
“Quando fiz meu doutorado, não havia estruturas para nenhuma das proteínas que investigávamos. Era como trabalhar no escuro: tínhamos que adivinhar o que estava acontecendo”, afirmou Grove. “Este conjunto de dados é uma ferramenta poderosa para quem está fazendo doutorado agora, porque oferece dados estruturais de alta qualidade que vão acelerar a ciência fundamental.”
Explore o conjunto de dados de complexos proteicos virais no AlphaFold Database Pandemic Preparedness Portal, preveja estruturas para alvos proteicos com o BioNeMo Structure Prediction Pipeline e saiba mais sobre o NVIDIA BioNeMo.