
Performance de sistema, escalabilidade eficiente de infraestrutura e otimização contínua de software são as alavancas que determinam a economia da inferência de IA. Mais performance de sistema significa mais tokens gerados e, portanto, mais receita. Escalar de forma eficiente significa que a vazão cresce proporcionalmente conforme o hardware é adicionado, exigindo menos recursos para atender usuários em escala. Otimização contínua significa extrair mais valor dos investimentos em infraestrutura.
Por trás das três está a fungibilidade da plataforma: a mesma infraestrutura roda qualquer modelo e qualquer carga de trabalho, de treinamento a inferência, de recomendação a raciocínio, de linguagem a vídeo, mantendo a utilização alta.
A plataforma NVIDIA foi construída para otimizar todos esses pontos, como mostram os resultados do MLPerf Inference v6.1 divulgados hoje:
- O sistema NVIDIA Vera Rubin NVL72 estreia com performance de destaque: na primeira submissão em preview ao MLPerf Inference, o NVIDIA Vera Rubin NVL72 entrega até 3,7x mais vazão que o GB300 NVL72.
- O NVIDIA GB300 NVL72 escala com alta eficiência: uma submissão com 288 GPUs em quatro racks GB300 NVL72 atingiu 99% de eficiência de escalabilidade, com a vazão crescendo de forma quase linear em relação à base de um rack.
- Otimizações contínuas de software geram ganhos de performance: as otimizações de software nas submissões da NVIDIA ao MLPerf Inference v6.1 entregaram até 1,6x mais performance que a v6.0. As otimizações continuaram depois da submissão da v6.1, com ganhos adicionais.
Para organizações que estão decidindo sobre infraestrutura de IA, performance, eficiência de escalabilidade e velocidade de software são considerações importantes, porque determinam a economia da inferência no longo prazo.
O Vera Rubin NVL72 estreia no MLPerf Inference com performance de destaque
A NVIDIA submeteu resultados em preview do Vera Rubin NVL72 em dois dos benchmarks mais exigentes da suíte MLPerf Inference v6.1: DeepSeek-R1 e Qwen3-VL.
O Vera Rubin NVL72 entrega até 3,7x mais vazão que o GB300 NVL72 no Qwen3-VL nos cenários offline, server e interactive, usando vLLM com o framework de inferência open source NVIDIA Dynamo. No DeepSeek-R1, com a biblioteca NVIDIA TensorRT-LLM, a vazão é até 2,5x maior que a do GB300 NVL72. Esses resultados iniciais mostram o ritmo de inovação da NVIDIA e como a performance deve melhorar com otimizações contínuas de software.
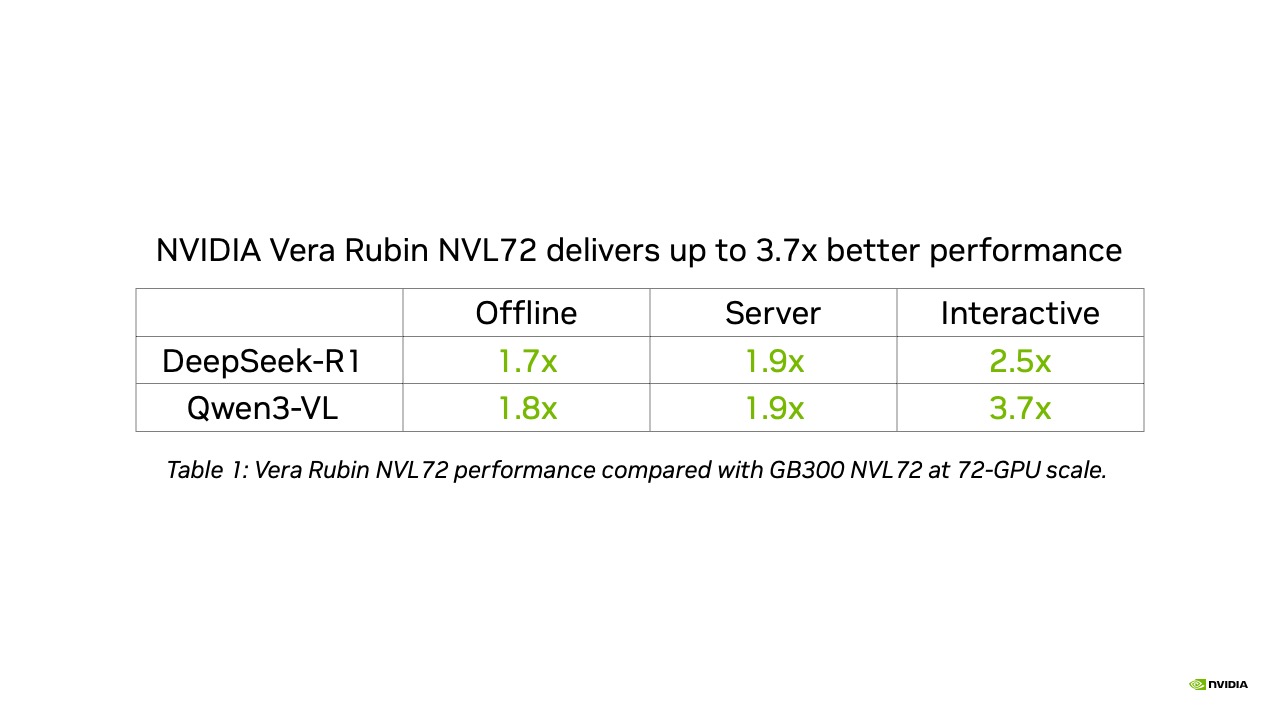
Na prática, cada rack Vera Rubin NVL72 entrega bem mais tokens, atende mais usuários e gera mais receita que um rack GB300 NVL72, reduzindo o custo por token.
Os resultados refletem codesign full-stack entre hardware e software. Os Tensor Cores e o Transformer Engine aprimorados do Vera Rubin aceleram tanto a fase de prefill quanto a de decode da inferência, enquanto a precisão NVFP4 reduz o consumo de memória em pesos do modelo, attention e KV cache, aumentando a vazão com perda mínima de qualidade na saída.
As submissões do Vera Rubin usaram bastante serving desagregado, separando prefill e decode, junto com paralelismo de especialistas em larga escala para máxima eficiência nas camadas mixture-of-experts que sustentam modelos como DeepSeek-R1 e Qwen3-VL.
O domínio de scale-up do NVL72, com a sexta geração de NVIDIA NVLink e NVLink Switch, entrega taxas de pacote 10x maiores e latência 3x menor que a Ethernet padrão de mercado, e é a base de interconexão que torna essas técnicas efetivas em escala de rack.
Esse codesign se estende ao ecossistema de parceiros da NVIDIA: a Nebius também submeteu resultados em preview do Vera Rubin NVL72 e demonstrou excelente performance.
Agentes de IA, que raciocinam, planejam e agem em várias etapas, estão mudando a forma de medir performance de inferência. Em benchmarks desenhados para capturar essa mudança, como o SemiAnalysis AgentX, o Vera Rubin NVL72 entregou performance 30x melhor que o GB300 NVL72 em testes de preview. Além disso, o futuro benchmark MLPerf Endpoints vai trazer medição padronizada para cargas de inferência com agentes, além do que os benchmarks tradicionais de vazão capturam.
O NVIDIA GB300 NVL72 escala com alta eficiência
Eficiência de escalabilidade, ou seja, o quanto GPUs adicionais se convertem em ganho de vazão, é uma medida central de produtividade de infraestrutura de IA. A NVIDIA entrega isso com interconexões de scale-up de alta banda e baixa latência dentro de cada rack, rede de alta banda entre racks e orquestração eficiente de requisições entre nós.
A submissão da NVIDIA no DeepSeek-R1 (DSR1) escalou de um rack GB300 NVL72 (72 GPUs) para quatro racks (288 GPUs), atingindo 99% de eficiência de escalabilidade no cenário offline. A vazão cresceu quase na mesma proporção do hardware adicionado.
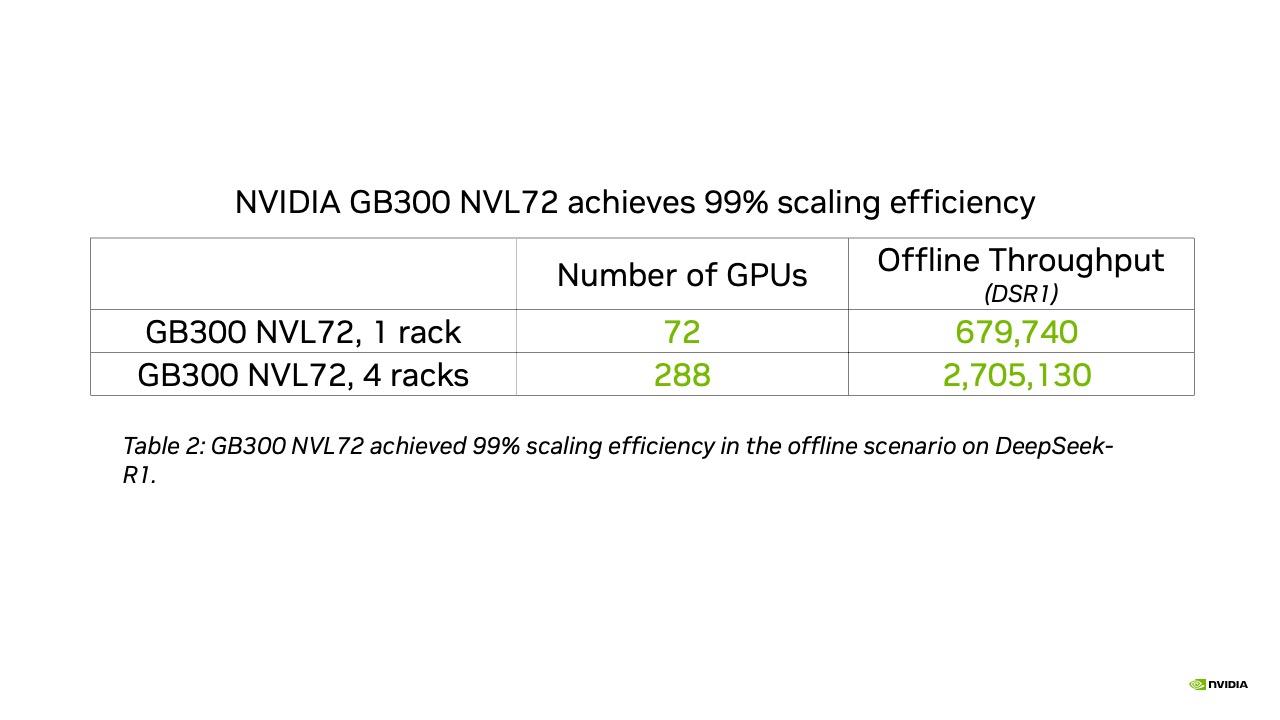
Eficiência de escalabilidade é decisiva porque mais GPUs não significam automaticamente vazão proporcionalmente maior. Se quase dobrar a quantidade de GPUs entregasse só um ganho de um dígito percentual em vazão, o custo de infraestrutura superaria de longe o retorno em performance. Arquitetura, interconexão e software precisam escalar em conjunto.
O GB300 NVL72 também demonstrou eficiência em escala de rack no benchmark de texto para vídeo WAN 2.2, chegando a 0,65 vídeo 720p por segundo ou 5,7 segundos por vídeo, vazão 9x maior e latência 7,5x menor que um único nó.
Otimizações de software geram ganhos contínuos
A plataforma NVIDIA passa por desenvolvimento contínuo de software, com melhorias de performance e de recursos.
Na v6.1, a performance do GB300 NVL72 no Qwen3-VL melhorou até 1,6x em relação aos resultados da v6.0. Os ganhos vieram de menor precisão no KV cache, mais fusão de kernels, kernels melhores e serving desagregado com vLLM e NVIDIA Dynamo.
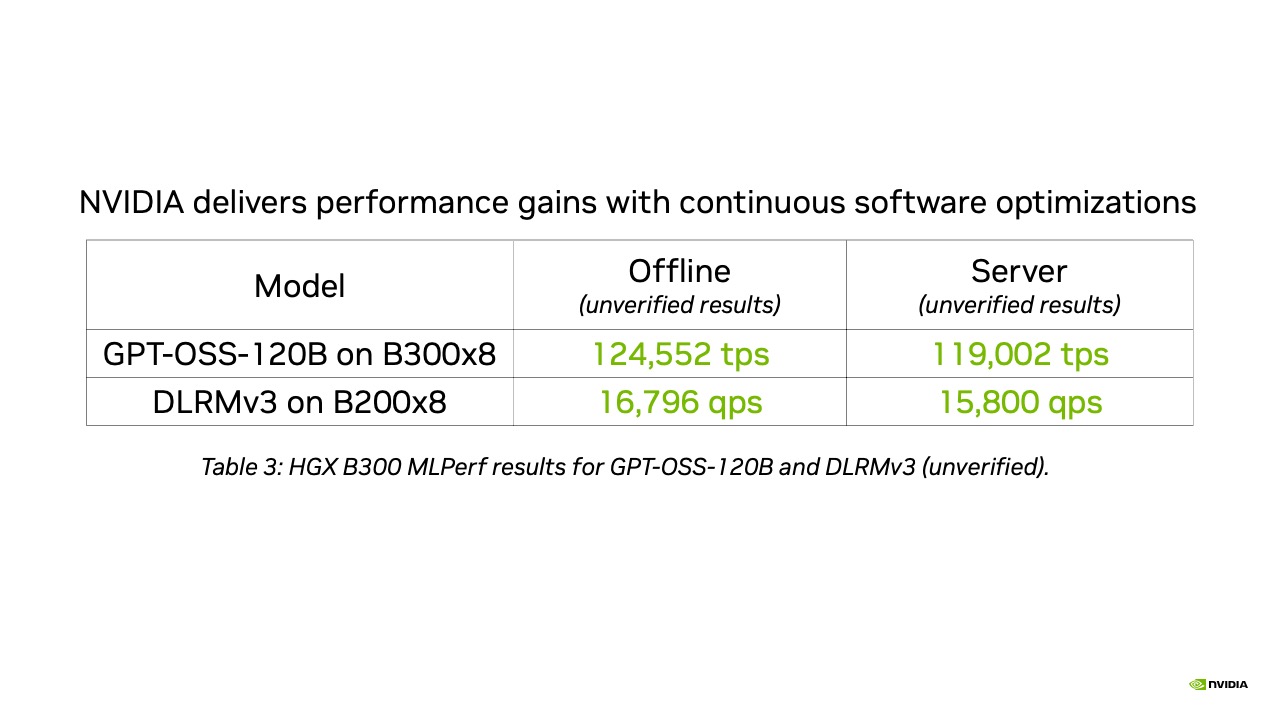
A otimização de software seguiu depois do prazo de submissão da v6.1. Resultados pós-submissão, ainda não verificados pela MLCommons, em GPT-OSS-120B e DLRMv3 mostram ganhos adicionais de performance.
Inferência de IA em qualquer escala
Além dos resultados da plataforma NVIDIA Grace Blackwell e Vera Rubin NVL72, a NVIDIA submeteu resultados do Jetson AGX Thor com o NVIDIA TensorRT Edge-LLM no novo benchmark Edge-Agentic, com o Qwen3.6-27B.
O ecossistema de parceiros da NVIDIA participou de forma ampla, com 19 parceiros, oito deles em sistemas Blackwell NVL72 multinó, demonstrando excelente performance. Entre eles: ASUS, Azure, Cisco, CoreWeave, Crusoe, Dell Technologies, Fujitsu, Giga Computing, HPE, Inventec, Lambda, MiTAC Computing, Nebius, Oracle Cloud Infrastructure, Quanta Cloud Technology, Red Hat, ScitiX, Supermicro e Wiwynn.
De dispositivos compactos na borda às grandes fábricas de IA, a NVIDIA segue avançando em performance por toda a stack, com cadência anual de arquiteturas de plataforma, software em melhoria contínua e um ecossistema construído para entregar isso em escala.
Saiba mais sobre a plataforma NVIDIA Vera Rubin.